Vraiment full-stack, maintenant avec des agents — la tech qui fait Minut (édition 2026)
Les développeurs de Minut interviennent sur toutes les couches du produit, du matériel et de l'électronique jusqu'aux moindres détails UI de l'application. Nous sommes fiers d'être véritablement full-stack, nous aimons cet artisanat, et nous serions ravis que d'autres personnes partageant cet état d'esprit rejoignent l'équipe.
Il y a presque cinq ans, nous parlions d'être vraiment full-stack : concevoir et construire mécaniques, électronique, firmware, backend, modèles ML, outils et applications mobiles et web en interne. Tout cela reste vrai. Mais la stack a évolué, et une chose a changé le quotidien de l'ingénierie ici plus que n'importe quoi d'autre depuis : nous construisons maintenant nos propres agents d'IA pour aider à construire et faire fonctionner Minut.
Voici donc l'édition 2026.
Minut est la couche d'intelligence pour la gestion proactive de biens immobiliers. Nous aidons les opérateurs de locations court terme, d'aparthotels, de logements étudiants et d'unités multifamiliales à rester en avance sur des problèmes comme le bruit, la fumée et la moisissure grâce à un petit capteur respectueux de la vie privée et à une plateforme qui transforme les informations en actions améliorant l'expérience des invités et les flux de travail des gestionnaires. Il y a des capteurs Minut dans plus de 100 pays. (Nous attendons toujours cette intro pour l'Antarctique, d'ailleurs.)
En bref
Voici ce que nous utilisons chez Minut en 2026 :
Web : React, TypeScript, Vite, TanStack Query, styled-components, et notre propre design system
Apps : Swift (SwiftUI), Kotlin (Jetpack Compose) — toujours entièrement natives
Backend : Node.js, TypeScript, Express, TypeSpec → OpenAPI, et un protocole TCP + Protocol Buffers personnalisé pour nos appareils
Données : MongoDB, MariaDB, Redis, OpenSearch, S3, PostgreSQL (notre entrepôt), et un moteur de séries temporelles interne appelé Granite
Infrastructure : AWS, Terraform, Kubernetes (EKS), GitHub Actions, et un registre Docker/Helm
Firmware : C, FreeRTOS, LwIP, Protocol Buffers, et du ML embarqué
Électronique : KiCad
Mécanique : Solidworks, Fusion 360
IA dans le produit : OpenAI (y compris l'API Realtime et Whisper) et OpenRouter
IA dans l'ingénierie : principalement Claude Code, incluant des skills partagés, des subagents, un réviseur IA sur chaque pull request, le signalement et la correction automatique de bugs, des monitors d'amélioration continue, et des apps internes en une commande
Travailler dans une équipe vraiment full-stack signifie apprendre de personnes aux compétences très variées. Nous continuons d'avoir des discussions techniques planifiées et spontanées sur l'architecture, les outils, l'expérience développeur et, de plus en plus, sur jusqu'où nous pouvons pousser les agents pour s'occuper des parties ennuyeuses à notre place.
Release et itération
Nous sommes une petite équipe soudée d'ingénieurs travaillant en étroite collaboration avec des designers, des PM et des parties prenantes. Les ingénieurs sont impliqués tôt dans le cadrage des problèmes, et nous préférons toujours publier plusieurs fois par jour, automatiquement, dès que la revue de code est passée.
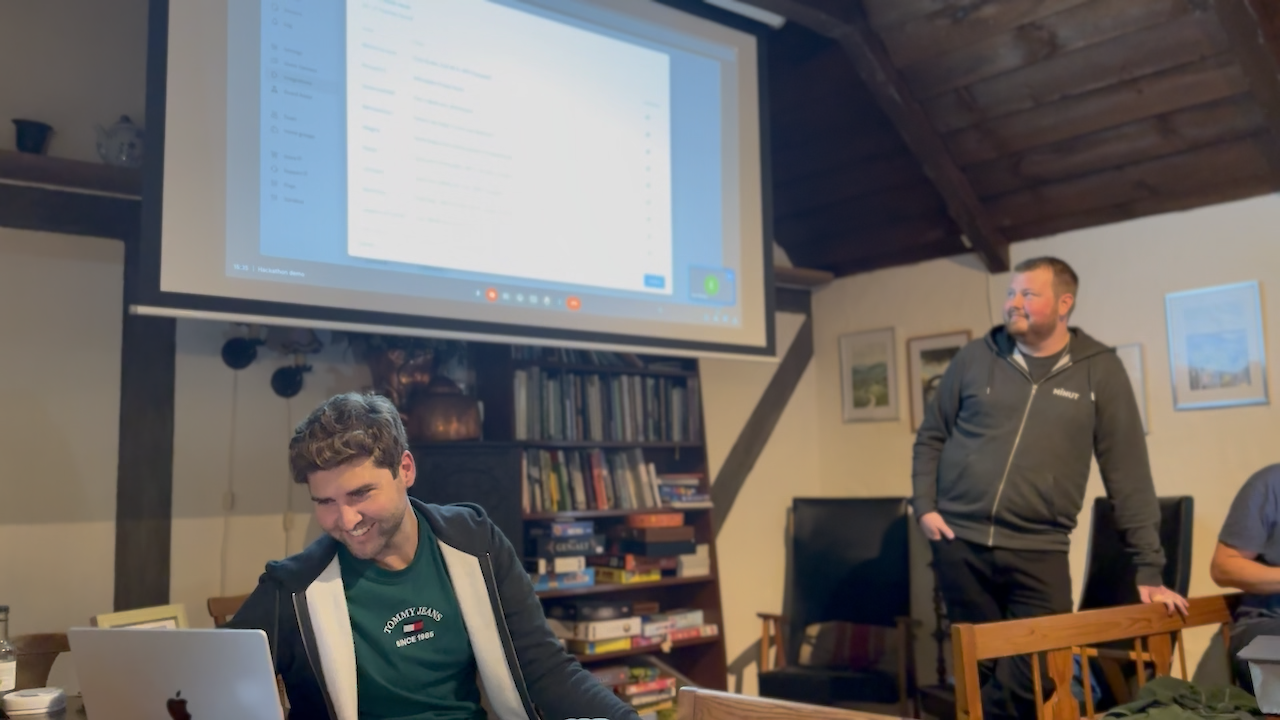
Des ingénieurs présentant lors d'un offsite d'ingénierie
Notre tableau de bord web sur web.minut.com est une application monopage construite avec React 19 et TypeScript, empaquetée avec Vite (nous avons abandonné Gatsby). L'état serveur est géré avec TanStack Query au-dessus de hooks API entièrement typés générés à partir de notre schéma OpenAPI, de sorte qu'un changement du contrat backend apparaît comme une erreur de type dans le frontend avant même d'être publié. Nous avons construit notre propre design system, affectueusement appelé meatball-ui, qui est maintenant le premier réflexe pour construire l'UI, stylé avec styled-components. Les tests tournent sur Vitest ; Prettier, ESLint et une vérification du code mort gardent les choses propres.
L'application web, et les applications mobiles, communiquent avec la même API HTTP RESTful versionnée que nos clients Pro et Enterprise intègrent. Le backend est une grosse base de code TypeScript (mode strict, partout) exécutée sur Node.js et Express. L'API est schema-first : nous la définissons en TypeSpec, la compilons en OpenAPI, générons des types à partir de celle-ci, et validons chaque requête contre le schéma à l'exécution. Elle est versionnée de v1 à v8, ce qui représente cinq ans d'évolution du contrat sans casser les clients qui en dépendent. Pas de GraphQL ; juste une API REST dans laquelle nous avons beaucoup investi.
Nos capteurs ne parlent pas HTTP. Ils maintiennent des connexions TCP persistantes sur TLS, échangeant des Protocol Buffers. Donc notre backend fonctionne réellement comme deux flottes : une plus petite servant l'API REST, et une plus grande tenant des dizaines de milliers de connexions d'appareils en direct simultanément. Garder autant d'appareils alimentés par batterie connectés, synchronisés, et peu coûteux en communication est l'un des problèmes les plus intéressants sur lesquels nous travaillons.
Conçu pour l'échelle
Derrière les capteurs se trouve une plateforme de données qui a beaucoup mûri. Nous faisons de la persistance polyglotte : MongoDB comme base opérationnelle principale, une couche relationnelle sur AWS RDS, Redis pour le cache et le rate-limiting, OpenSearch pour les logs d'appareils et d'audit, et S3 pour les objets. Les mesures brutes par minute des capteurs sont énormes, donc nous avons construit Granite, un moteur de séries temporelles interne qui garde une fenêtre chaude en SQL et bascule tout le reste dans un stockage froid moins cher.
Pour l'analytics, nous exécutons un entrepôt PostgreSQL qui unifie un clone du backend, le flux d'événements, la facturation, et des centaines de tables d'analytics produit en un seul endroit interrogeable.
Nous ne divulguons pas l'échelle, mais suivre la croissance est l'un des défis d'ingénierie les plus enthousiasmants sur lesquels nous travaillons en continu. Un bug publié négligemment atteint beaucoup de foyers, c'est pourquoi nous prenons les tests et l'observabilité au sérieux (New Relic, Rollbar, Grafana, Prometheus, OpenSearch), et pourquoi notre CI/CD est entièrement automatisée : GitHub Actions avec runners auto-hébergés construit et teste chaque changement, pousse une image vers notre registre Docker, déploie sur Kubernetes, et poste le résultat sur Slack et annote Grafana. (Jenkins, notre cheval de bataille de 2021, est pour l'essentiel retiré maintenant.) Toute notre infrastructure est en Terraform.
La vie privée au cœur
Cette partie n'a pas changé, parce que c'est le point central. La surveillance respectueuse de la vie privée est simple en principe et difficile en pratique, et nous avons conçu une manière nouvelle d'identifier des événements spécifiques sur des capteurs alimentés par batterie sans compromettre la vie privée des invités (brevet US US20200143823A1).
Les données brutes sont traitées directement sur le capteur et jamais partagées avec Minut ni avec quiconque. Lorsqu'un appareil détecte un événement potentiellement critique, par exemple du verre brisé, une montée de température brutale, ou une hausse prolongée du bruit, il envoie un compact empreinte (fingerprint) de cet événement vers le cloud, où des modèles plus puissants examinent de plus près avant que quoi que ce soit n'atteigne l'utilisateur. Le capteur n'a pas de caméra et n'enregistre pas d'audio. Il ne l'a jamais fait, et ne le fera jamais.
Oui, cela signifie toujours exécuter des modèles ML entraînés sur un microcontrôleur avec 96 MHz et moins de 256 kB de RAM, sur batterie, jusqu'à un an. Et la gamme de choses que nous pouvons détecter sur l'appareil s'est élargie : fumée de cigarette, estimation de foule et d'occupation, risque de moisissure, et les sons d'autres alarmes. Lisez-en plus sur notre approche de la vie privée.
IA dans le produit
Détecter un problème est la moitié du travail. L'autre moitié est d'aider les opérateurs à agir dessus sans être de garde à 3h du matin, et c'est de plus en plus là que l'IA intervient dans le produit.
Nous sommes pragmatiques sur les modèles que nous utilisons et où nous les utilisons. Nos fonctionnalités IA orientées client fonctionnent sur OpenAI (et OpenRouter comme passerelle secondaire), gérées via un système de prompts versionné et persisté en base de données, afin que nous puissions itérer sur les prompts comme nous itérons sur le code. Quelques-unes des choses que cela alimente :
Messages Autopilot : réponses rédigées par l'IA dans le ton choisi par l'hôte, de sorte qu'un rappel de bruit ou une question de check-in parte au bon moment sans que personne ne le tape.
Appels vocaux IA : nous relions Twilio Media Streams à l'API Realtime d'OpenAI, avec Whisper pour la transcription, afin que Minut puisse téléphoner à un invité lorsque le bruit dépasse la limite (notre service Call Assist), et même effectuer des appels de bien-être pour des résidents vulnérables, en classifiant si un suivi est nécessaire.
Un assistant de tâches conversationnel, des recommandations générées par l'IA pour les invités, et un appariement d'entités par IA qui maintient les intégrations correctement liées.
L'IA exécute toute notre pipeline de localisation : les traductions vivent sous forme de YAML dans leur propre repo, et chaque push déclenche une GitHub Action qui auto-traduit en sept langues (le japonais est le plus récent) et distribue les résultats vers le web, le backend, la vitrine, iOS et Android.
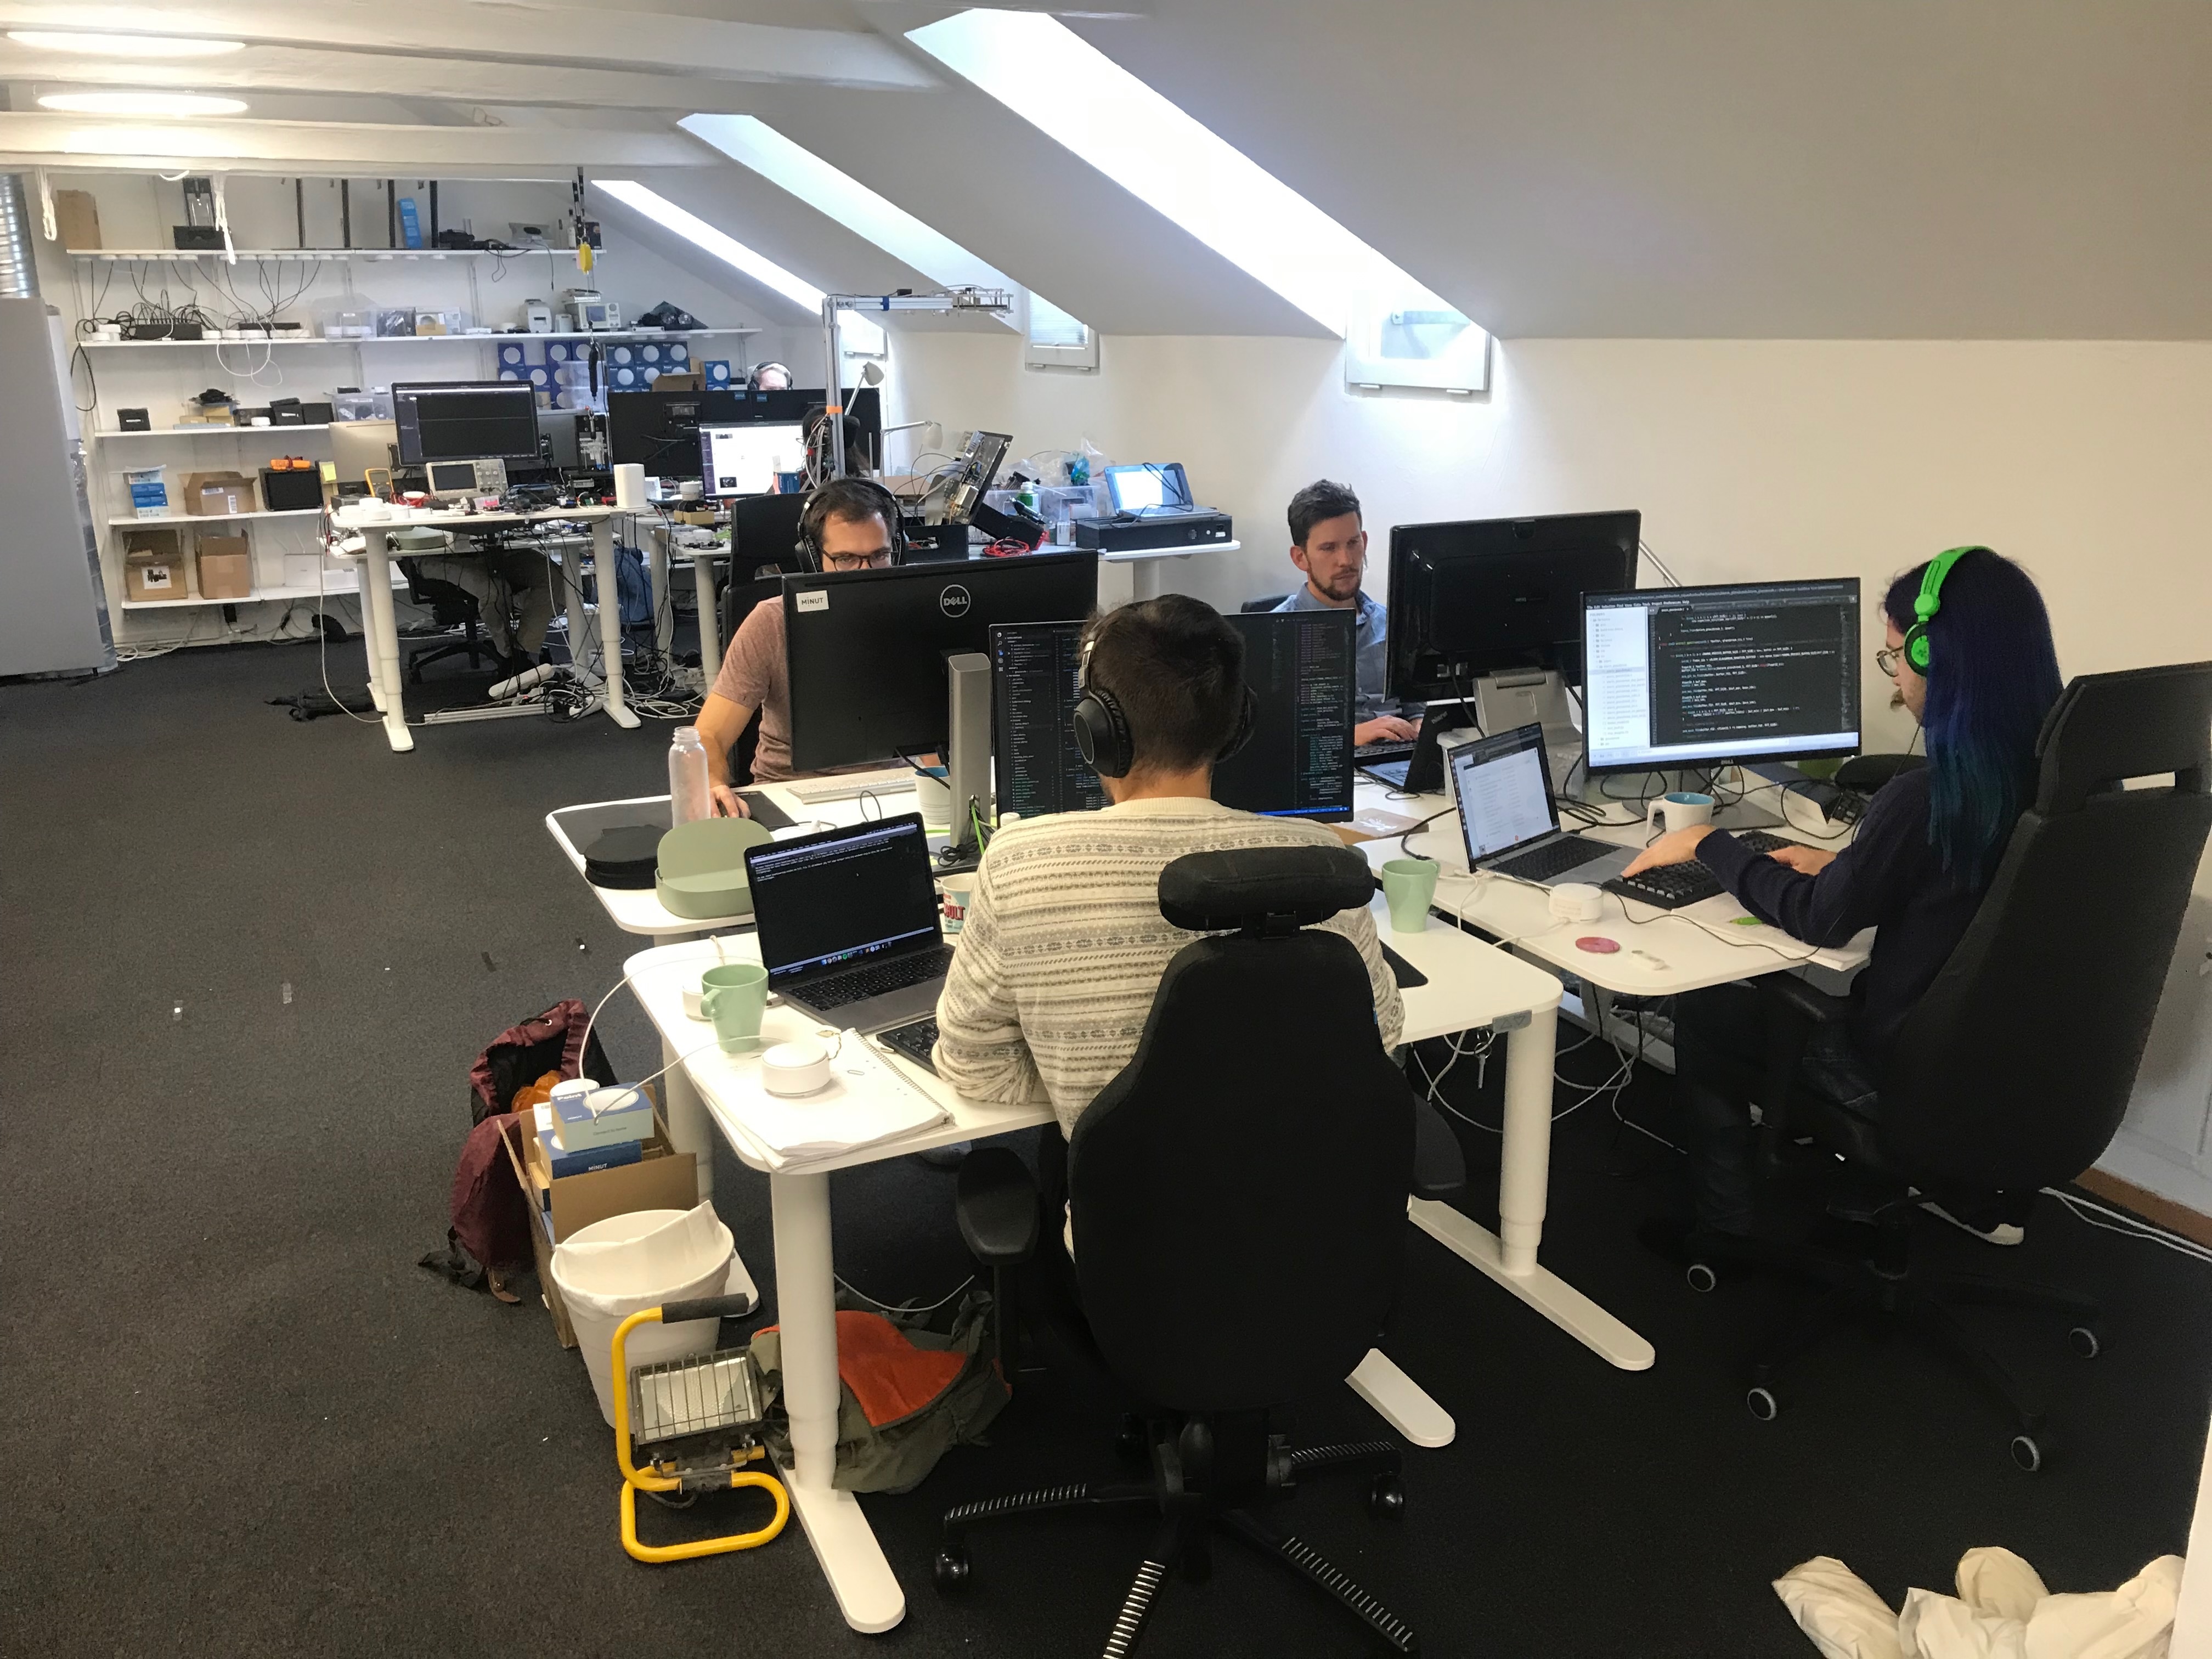
L'équipe data concentrée au travail dans l'ancien bureau de Minut à Malmö
Des agents qui construisent et font fonctionner Minut
Voici le plus grand changement depuis 2021, et celui qui nous enthousiasme le plus. Si OpenAI alimente le produit, Claude Code d'Anthropic alimente notre ingénierie et nous nous y sommes fortement engagés, pas comme une fenêtre de chat accessoire mais comme une vraie infrastructure tissée dans notre façon de travailler.
Chaque pull request est revue par l'IA avant qu'un humain ne la regarde. Un bot exécute plusieurs CLIs d'agents de codage en parallèle sur des runners auto-hébergés en faisant des passes séparées pour les bugs, la sécurité, les conventions et les exigences, plus une passe de consolidation avec un « guide du réviseur » lisible par un humain sur le changement. Il récupère le ticket Jira pertinent pour le contexte, poste de vrais commentaires inline sur les lignes exactes, et une fois qu'un humain approuve, il peut approuver en tant que propriétaire de code.
Un autre ensemble d'agents surveille les releases et fait en continu deux choses : premièrement, mettre à jour la documentation interne et externe pour que notre centre d'aide et l'équipe soient toujours à jour. Et deuxièmement, rechercher des bugs et corrections courants que l'IA peut apprendre pour améliorer le développement futur.
Créer un nouvel outil interne, c'est une commande. Notre plateforme d'apps internes (MIAS) provisionne une application de production complète de bout en bout depuis une seule commande : repo, base de données, auth, hébergement, DNS, secrets, entrée de registre. Les nouvelles apps sont natives-agent dès leur naissance : le scaffolder injecte le contexte et les skills dont Claude a besoin, donc Claude vous interroge sur ce que vous construisez puis écrit la première fonctionnalité lui-même. Chaque app hérite gratuitement de la connexion partagée, de Slack et de l'email, plus d'un widget de retour qui crée un ticket directement pour le propriétaire sans tri humain intermédiaire.
La même philosophie traverse nos opérations. Nous maintenons une bibliothèque partagée de skills et subagents Claude Code que tout ingénieur installe localement pour démarrer un ticket, le répartir sur les plateformes, s'auto-revoir, déboguer une erreur Sentry, ou livrer.
Nous avons un workflow qui prend une erreur en production jusqu'à une PR testée et prête par lui-même, pilotant un CLI spécialement conçu que nous avons écrit pour qu'un agent puisse le consommer.
Rien de tout cela ne remplace les ingénieurs. Cela supprime les tâches répétitives autour d'eux comme le boilerplate, la revue de premier passage, le provisioning, l'archéologie « pourquoi cette erreur arrive » afin que les décisions intéressantes reçoivent davantage de notre attention. Si construire et vivre dans ce genre d'environnement vous paraît amusant, vous vous y entendrez bien.
Applications natives
Les applications mobiles de Minut sont toujours développées nativement sur iOS et Android. Ce qui a changé, c'est que nous sommes maintenant fermement dans l'ère déclarative moderne : iOS est SwiftUI-first et Android est Jetpack Compose-first sur Kotlin. Protocol Buffers restent l'épine dorsale de la communication des deux apps avec les appareils, en miroir du firmware.
Nous gardons l'esprit ouvert sur le code partagé et la vitesse de développement, mais pour nous le natif reste la bonne base.
Le hardware, c'est dur (lire : fun)
Depuis le début, nous concevons, prototypons et construisons nos propres mécaniques, électroniques et firmware en interne. Nous choisissons les meilleurs composants et les intégrons avec notre stack firmware en C pour construire un système qui respecte la vie privée des invités par conception.
Des gabarits matériels et des logiciels personnalisés, développés en interne, collectent et uploadent des statistiques sur chaque unité dès la sortie de ligne de production, afin que nous puissions faire monter en continu la qualité matérielle. Le firmware est mis à jour over-the-air après l'installation d'une unité dans le domicile ; au fil des années ces mises à jour ont amélioré l'autonomie de la batterie de plus de 100% et ajouté des fonctionnalités que nous n'avions même pas imaginées au lancement. Nous avons aussi construit un Remote Debug Service basé sur navigateur pour pouvoir parler en toute sécurité à un appareil sur le terrain pour récupération et diagnostics. Tout cela est rendu possible par un laboratoire hardware bien équipé dans notre bureau du centre de Malmö.
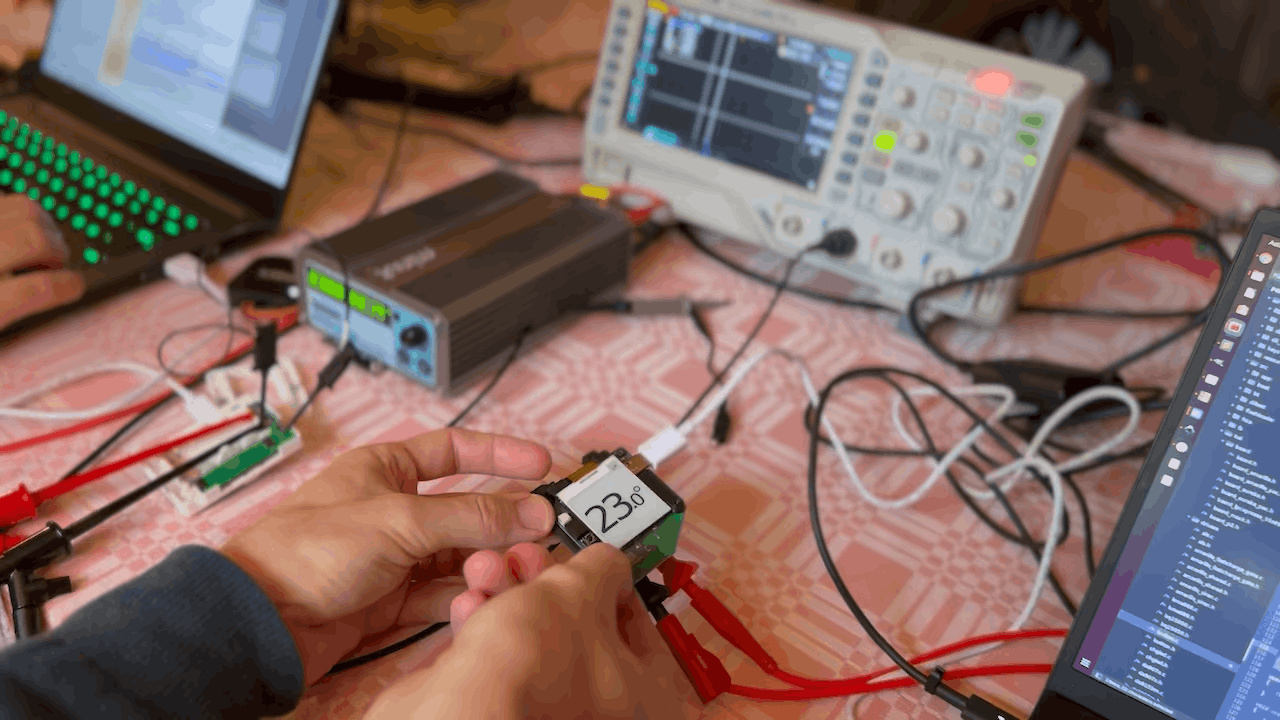
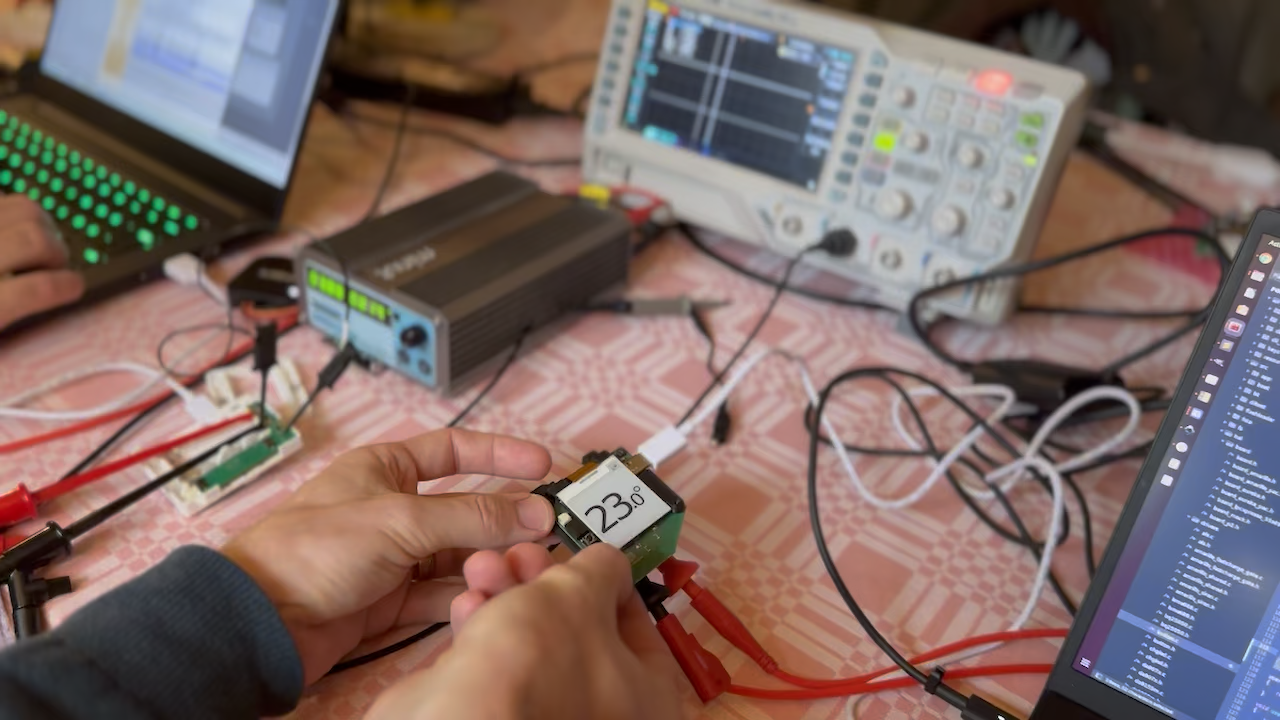
Construction d'un prototype physique lors d'un de nos offsites d'ingénierie.
Minut en boîte
Pour gérer des capteurs dans plus de 100 pays, nous avons construit une suite rigoureuse de tests et d'automatisation pour minimiser le risque d'expédier quelque chose qui perturbe un capteur dont dépend l'activité d'un client.
Tout développeur peut lancer un environnement complet sur sa machine locale (ou distante), avec des outils pour émuler utilisateurs, apps et capteurs matériels. Notre suite de tests scénario boîte noire exécute le vrai backend dans Docker contre des versions factices de chaque service tiers que nous intégrons afin que nous puissions tester des flux entiers de manière déterministe. Et notre flotte de test interne de plus de 100 capteurs physiques est continuellement exposée à différents environnements, versions de firmware, configurations logicielles et routeurs.
Les outils et l'automatisation sont une moitié ; les workflows sont l'autre. Chaque équipe utilise la revue de code rigoureusement (maintenant avec un passage IA en premier), pair-programme fréquemment, et publie en continu sur toutes les parties de la stack.
Rejoignez notre équipe full-stack
En tant qu'ingénieur chez Minut, vous pouvez travailler sur l'ensemble : de l'électronique, au firmware exécutant du ML sur un tout petit microcontrôleur, à un large backend TypeScript, aux animations dans une app native, jusqu'aux agents qui construisent et examinent tout cela. Nous sommes une organisation véritablement full-stack, nous aimons ce que nous faisons, et nous recherchons des personnes partageant cet état d'esprit pour rejoindre notre équipe d'ingénierie en croissance.